Tentang Kami
Masih Input Data Karya Ilmiah Secara Manual?
Pengolahan data skripsi, tesis, dan disertasi sering dilakukan secara manual. Hal ini memakan waktu, rentan kesalahan, dan tidak efisien—terutama jika jumlah dokumen sangat banyak.
Read MoreWebsite ini hadir untuk:
- Menghemat waktu input data
- Mengurangi human error
- Membantu perpustakaan dan institusi akademik
- Mempercepat proses digitalisasi
Layanan
Berikut layanan Skripsci yang dapat membantu Anda
Ekstraksi Metadata Otomatis
Mengambil data penting seperti Nama, NIM, Fakultas, Program Studi, Tahun, dan Judul langsung dari file PDF karya ilmiah secara cepat dan akurat tanpa perlu input manual.
Analisis & Identifikasi Abstrak
Sistem mampu mendeteksi dan mengekstrak bagian abstrak secara otomatis, meskipun format dokumen berbeda-beda.
Validasi & Pratinjau Hasil
Sebelum data disimpan atau diunduh, pengguna dapat meninjau dan memverifikasi hasil ekstraksi untuk memastikan akurasi dan kelengkapan informasi.
Export & Integrasi Data
Hasil ekstraksi dapat diunduh dalam format PDF dan siap digunakan untuk kebutuhan repository, sistem akademik, atau pengolahan data lanjutan.
Fitur Unggulan
Berikut beberapa fitur unggulan dari Skripsci
Ekstraksi Otomatis
Mengambil data penting dari file PDF karya ilmiah secara otomatis menggunakan sistem pemrosesan teks cerdas.
Deteksi Struktur
Mampu mengenali halaman sampul, halaman abstrak, serta identitas dari penulis/peneliti
Export Data
Sistem dapat menampilkan hasil ekstraksi untuk ditinjau dan dapat diunduh dalam format PDF.
Mulai Sekarang dan Nikmati Kemudahannya !
Mulai proses ekstraksi dan rasakan kemudahan otomatisasi data karya ilmiah.
Frequently Asked Questions
Pertanyaan yang sering ditanyakan pengguna
01 Format file apa saja yang didukung?
Saat ini sistem mendukung file dalam format PDF karya ilmiah berupa skripsi, tesis, dan disertasi.
02 Apakah sistem bisa memproses file hasil scan (gambar)?
Ya. Website ini dilengkapi dengan fitur OCR (Optical Character Recognition) yang memungkinkan sistem membaca teks dari dokumen hasil scan atau PDF berbasis gambar. Dengan teknologi ini, data seperti Nama, NIM, Judul, dan Abstrak tetap dapat diekstrak meskipun file bukan berbasis teks digital.
03 Seberapa akurat hasil ekstraksi datanya?
Sistem dirancang untuk mengenali pola umum dokumen akademik dan mampu mengekstrak data dengan tingkat akurasi tinggi. Namun, karena setiap institusi memiliki format berbeda, kami menyediakan fitur pratinjau agar pengguna dapat memverifikasi hasil sebelum digunakan.
Developer
Profil Developer (Tim Pengembang)
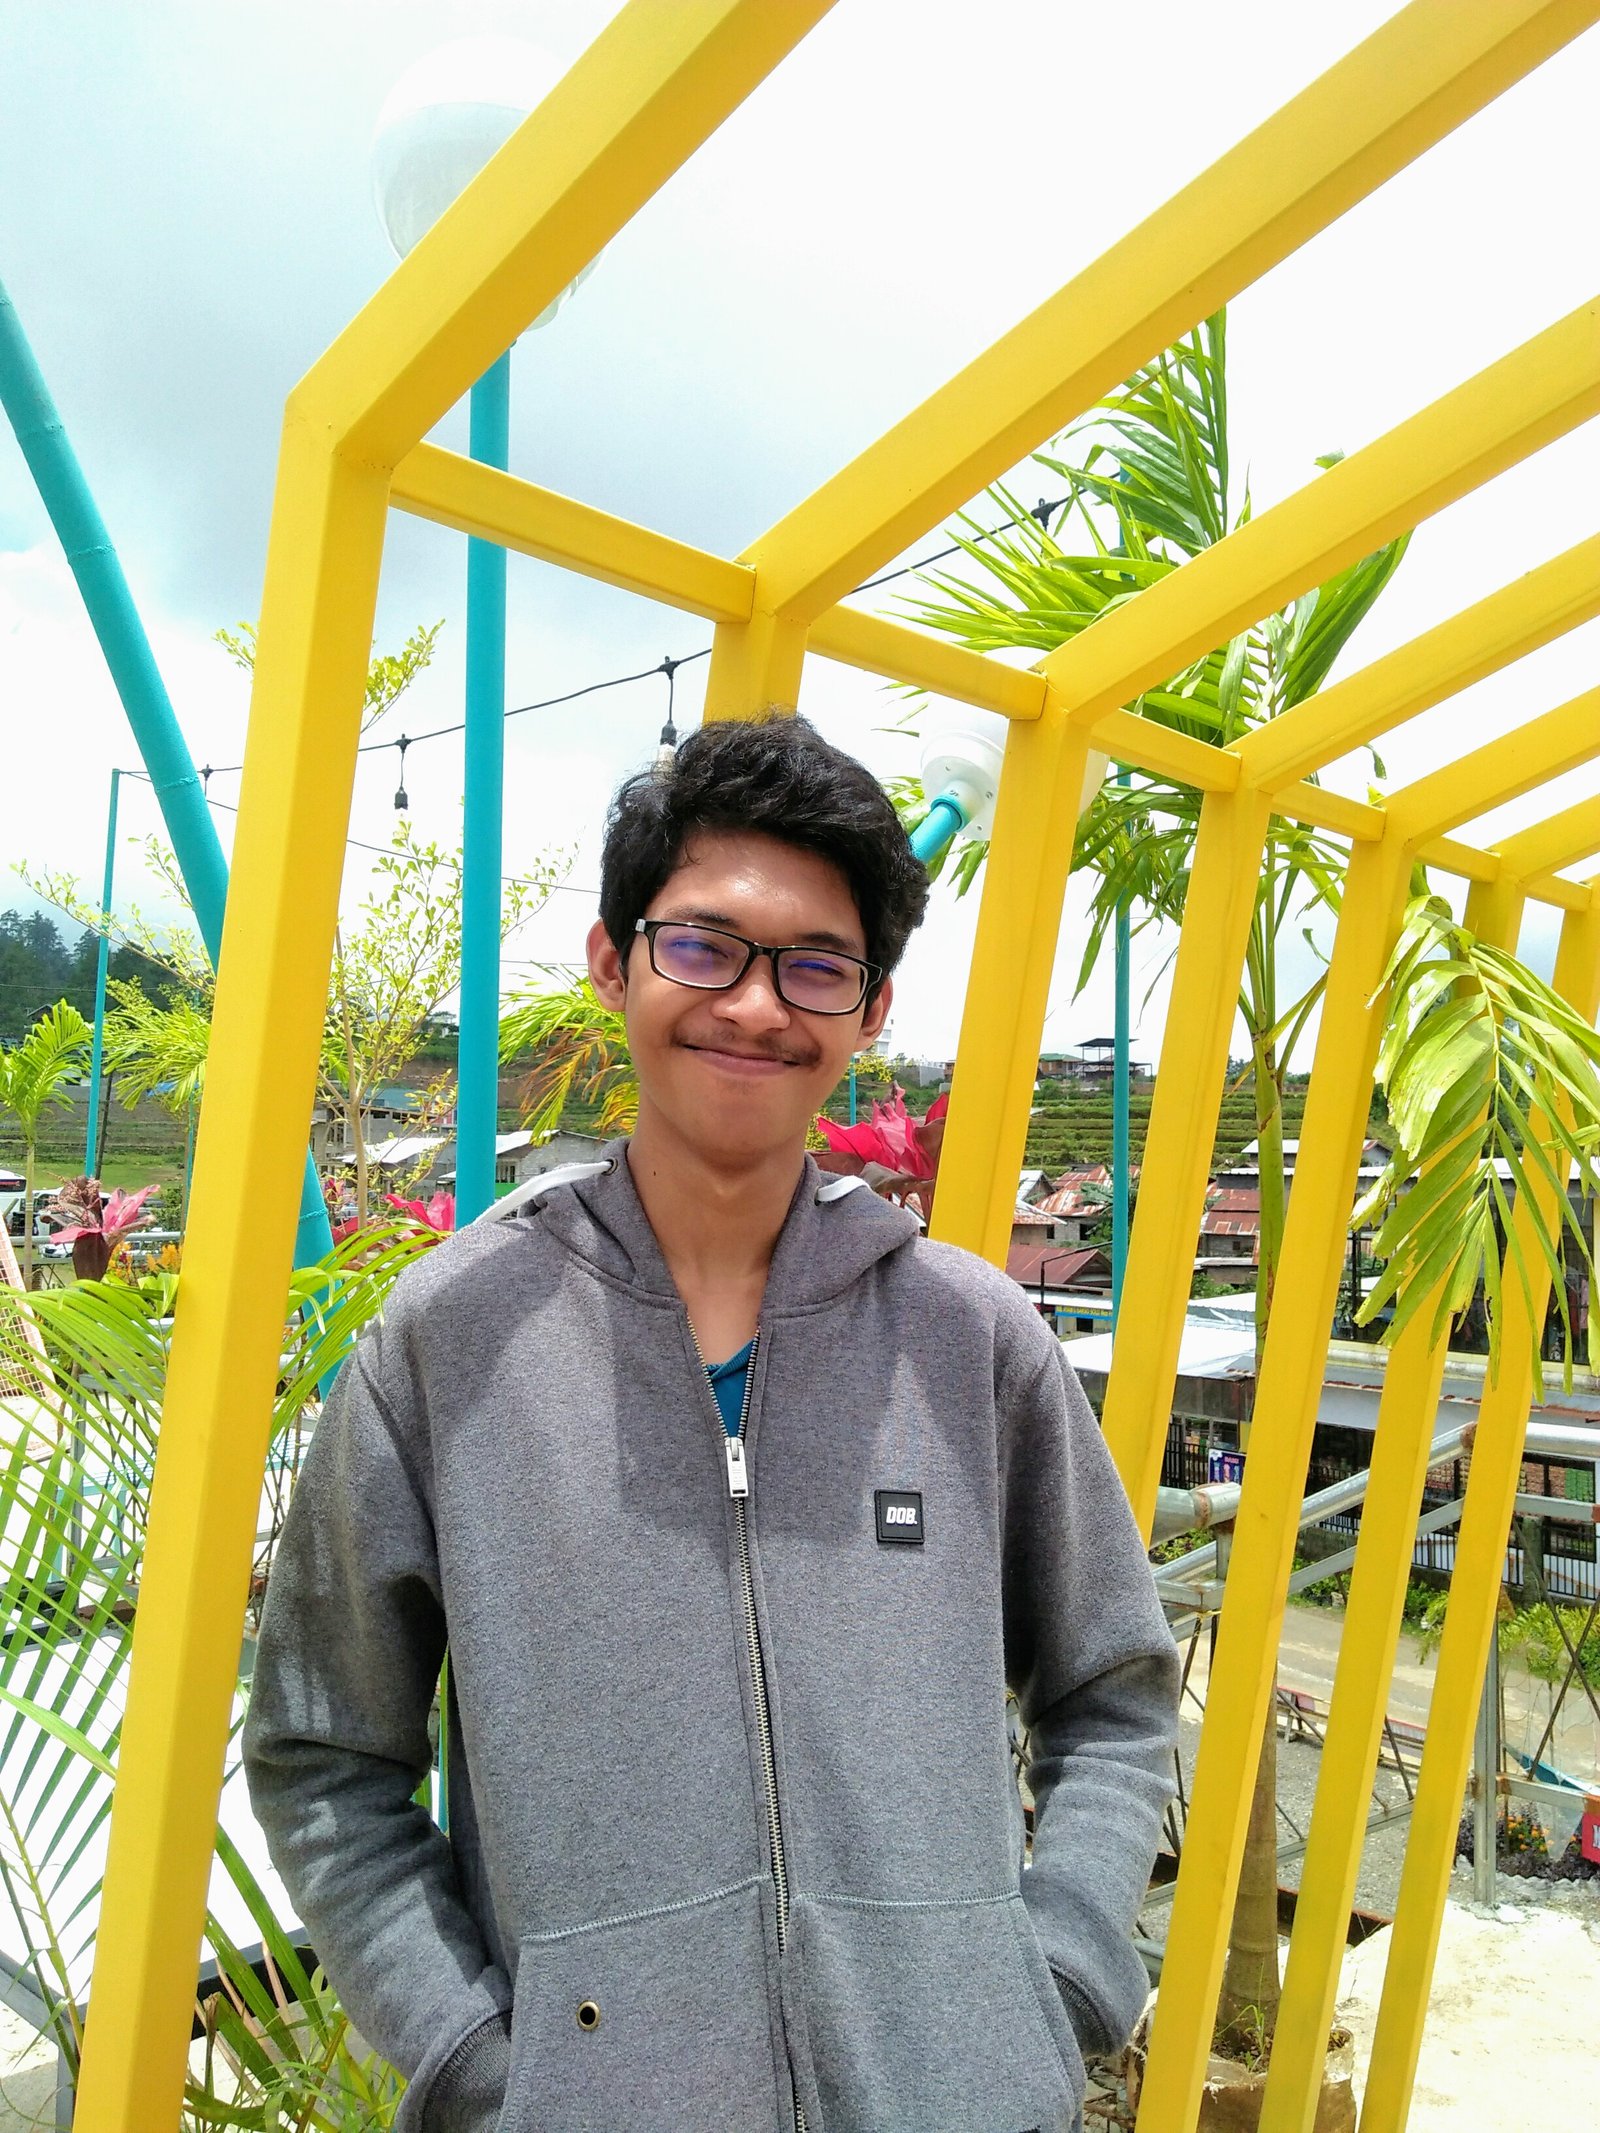
Trisakti Akbar, S.Kom
Web DeveloperTim pengembang website Skripsci
Kontak
Hubungi kami dan tim kami akan segera membantu Anda
Alamat
Gowa, Sulawesi Selatan
Telepon
+62 823-4564-8742
trisaktiakbar01@gmail.com